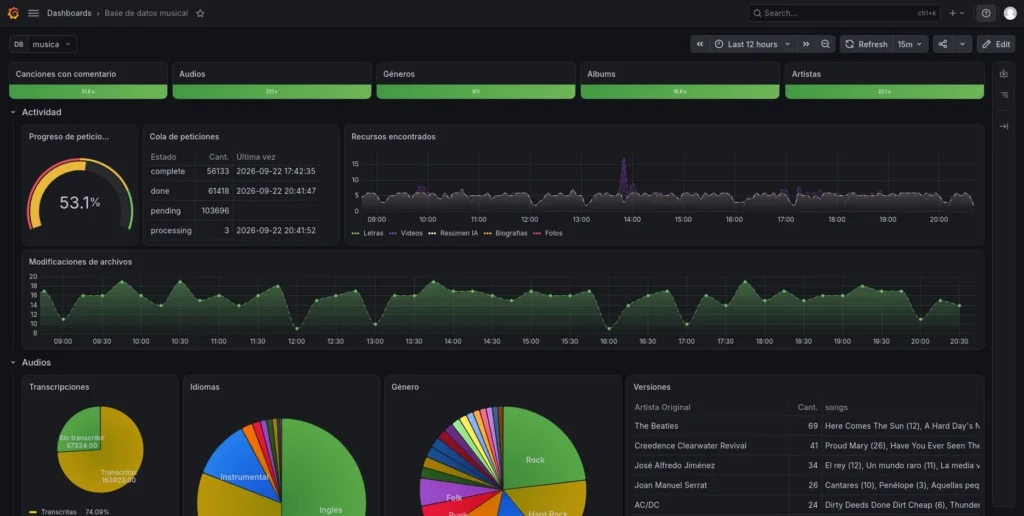
Business Intelligence para un proyecto personal: el panel de Grafana de Gramola
Cuando alguien dice "Business Intelligence" casi todo el mundo piensa, lo primero, en una empresa grande, con un data warehouse, licencias caras y un equipo entero mirando cuadros de mando. Y no, no hace falta nada de eso, porque la misma idea se puede aplicar a un proyecto personal, aunque nadie te lo pida y aunque no haya un cliente esperando ningún informe. En Gramola, el proyecto de catalogación musical que tengo en casa, esa parte la cubre un panel de Grafana, el cual se apoya directamente sobre la base de datos PostgreSQL del propio proyecto y que, sin florituras, me dice en un vistazo cómo está la cosa por dentro.
Conviene aclarar, antes de nada, de qué datos hablamos. Aquí el sujeto no son los ficheros de audio, sino la información que se reconstruye sobre los artistas: biografía, discografía, portadas, letras, géneros, años y todo lo que se puede recopilar de fuentes públicas repartidas por media internet. Es decir, un catálogo de metadatos que se levanta consultando muchas webs distintas, no una biblioteca de archivos.
Y ese catálogo cumple dos funciones la mar de útiles. La primera es la de hacer de enciclopedia: tener a mano quién es cada artista, qué discos sacó y en qué año. La segunda es ilustrar los audios de mi colección, de modo que cada tema lleve su información guardada en los metadatos y no dependa de tenerla en ningún sitio aparte. Conviene entender bien la escala, porque el panel trabaja con la globalidad de los datos recopilados, que es muchísima; dentro de todo ese conjunto hay un apartado que me dice qué cantidad de audios reales tengo guardados, que serán muchos menos… de hecho no te das cuenta de la cantidad de artistas y obras que hay publicadas desde el año 1900 en adelante, que es de cuando tengo los primeros registros.
Qué es el panel
El panel es un dashboard de Grafana que vive dentro de la aplicación, en la pantalla de Estadísticas, embebido con un iframe y configurable desde los ajustes con una URL y una API key. Grafana, aquí, no guarda datos por su cuenta: lo que hace es consultar la base de datos musica con SQL y pintar el resultado. Así que todo lo que se ve en las gráficas sale de las tablas, las cuales ya usaba el backend en Rust (Axum, Tokio y SQLx): artists, albums, songs, data_fetch_log, requests_queue y unas cuantas más.
Y aquí está, en mi opinión, la parte que merece la pena: esto no es un cuadro de mando decorativo. Esto es una herramienta de trabajo, la cual enseña el estado real de un sistema que se pasa el día haciendo cosas por su cuenta: lanzando scrapers, resolviendo consultas contra distintos proveedores y rellenando huecos de información. Y todo eso, al final, acaba embebido en los propios archivos multimedia (etiquetas ID3, portadas, letras, biografías), que es donde de verdad tiene que estar. No es en absoluto un detalle menor, además, el hecho de que todo ese trabajo invisible se pueda ver de golpe.
Qué mide
El panel tiene unos 64 paneles repartidos en tres bloques: Base de datos musical, Actividad y Audios. Cada uno responde a una pregunta distinta.
En el bloque de Base de datos musical, los números grandes de arriba: canciones con comentario, audios, géneros, álbumes y artistas. Y aunque aquí aparezca la palabra audios, conviene leerlo como lo que es: el volumen del catálogo de metadatos, que es enorme comparado con cualquier biblioteca personal. Ahí es donde tiene sentido el apartado que dice cuántos audios reales tengo guardados: unos pocos, dentro de todo ese maremagnum de información sobre artistas y discos.
En Actividad, que es donde de verdad me entero de lo que pasa, aparecen la cola de peticiones (completadas, hechas, pendientes y en proceso, con su última vez), los recursos encontrados por tipo (letras, vídeos, resúmenes con IA, biografías y fotos) y las modificaciones. La cola, esa sí que es una señal muy directa de salud: si el número de pendientes se dispara y no baja, algo se ha atascado, y me entero antes de que el problema se haga grande.
En Audios están los porcentajes de transcripción, los idiomas, el reparto por género y las versiones por artista original, además de la cobertura de metadatos: porcentaje con artista, con año, con BPM, con número de pista y con total de pistas. Todos esos porcentajes responden a la misma pregunta: ¿cuánta información de la que quiero tener está realmente completa? Y, si me apuras, también hay paneles que cazan cosas que no me esperaba, como los posibles duplicados por título y artista. Hay que tomar en cuenta que las cosas pueden variar según cómo se mire, pero esos números, al final, son los que mandan.
Qué aporta esto al Business Intelligence
Llegados a este punto, la pregunta es qué tiene que ver todo esto con el Business Intelligence. La respuesta es más sencilla de lo que parece: BI, en el fondo, es convertir datos en decisiones, y eso es exactamente lo que hace el panel.
- Da contexto a los datos. Sin el panel, tener miles de registros es un número. Con él, es un catálogo que puedo comparar con la información ya recopilada y ver cuánto me queda por cubrir.
- Detecta anomalías sin buscarlas. La evolución del éxito y el fallo de las consultas, o los proveedores que fallan en
data_fetch_log, saltan solos. Antes de tener esto, me enteraba de los problemas porque algo dejaba de funcionar. - Prioriza el trabajo. Ver qué falta (por ejemplo, registros sin año o sin portada) es lo que decide qué scraper ajusto después. Los datos eligen por mí.
- Mide el resultado de un cambio. Cuando toco un scraper o una consulta, el panel me dice si de verdad ha servido de algo.
Y luego está el detalle de que todo esto está self-hosted, montado con Docker, sin pagar un euro a ningún servicio externo. Grafana, PostgreSQL y el resto viven en mi propio servidor, en el homelab que tengo en casa. Que el BI también se pueda hacer así, con herramientas libres y sobre tus propios datos, es algo que merece la pena tener presente; al final viene a ser lo mismo que persigo con el resto de servicios: soberanía digital, decidir yo dónde viven los datos y quién puede mirarlos.
Cómo está montado
Si alguien quiere llevarse la idea, la receta es corta. Grafana corre en su contenedor, apunta al datasource de PostgreSQL del proyecto y el dashboard se exporta como JSON (grafana-dashboard.json) para poder importarlo en cualquier instancia. Las consultas, todas SQL directas sobre las tablas que ya existen; no hizo falta tabla nueva ni capa intermedia. El dashboard incluso se puede enlazar desde la aplicación con una URL con API key.
A esto se le puede sumar, cuando el proyecto crece, la parte de observabilidad más clásica: exponer métricas con Prometheus para vigilar el propio sistema (memoria, procesos, tiempos de respuesta) y no solo los datos. Al final es la misma idea llevada un paso más allá: si voy a mirar paneles para decidir, mejor tenerlos también del estado interno del sistema.
Conclusión
En resumidas cuentas: el panel de Grafana de Gramola no es un adorno. Es la forma de ver, medir y decidir sobre un catálogo de metadatos que se ha vuelto lo bastante grande como para necesitarlo. Un panel que empecé montando para echar un ojo a las consultas y que acabó siendo la herramienta con la que entiendo el sistema entero. Y todo con software libre, con la información recopilada de fuentes públicas y embebida en los propios archivos, sin depender de nadie.