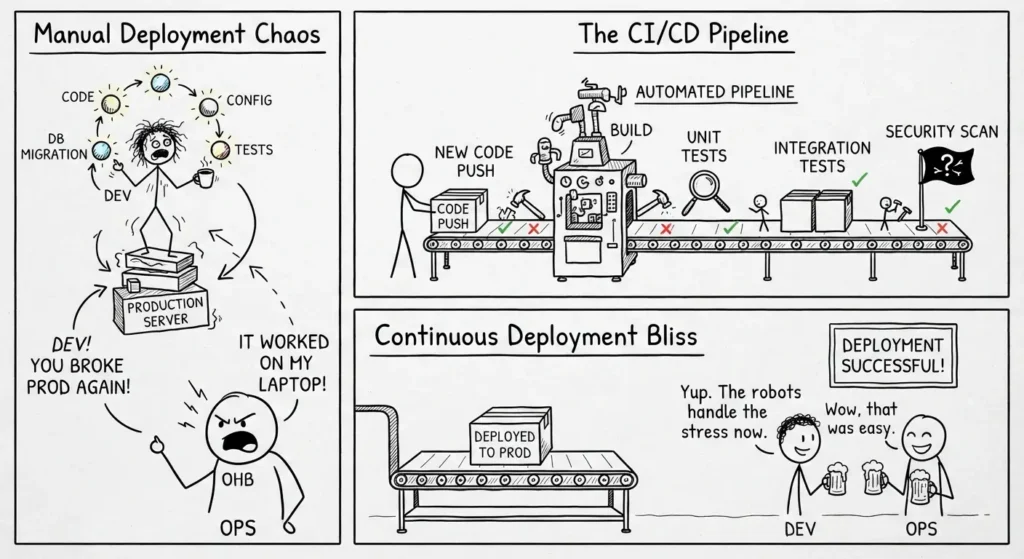
CI/CD: qué es y por qué ahorra tiempo
Hay una escena que se repite en casi cualquier equipo: alguien sube un cambio, todo el mundo sigue a lo suyo, y un par de días después resulta que la aplicación no compila. Lo peor, siempre, es lo mismo, y es que nadie se entera hasta que ya es tarde. Pues precisamente de eso van la integración continua y el despliegue continuo, de no dejar que los errores se acumulen hasta el peor momento posible.
Qué es la integración continua
La integración continua, o CI, es la práctica de fusionar el código de todo el equipo en un repositorio compartido con frecuencia, y de verificar de forma automática cada una de esas fusiones. La idea, en el fondo, es sencilla: cada cambio pasa por una compilación y por las pruebas en cuanto llega al repositorio, de modo que el error se detecta cuando todavía es barato de arreglar.
Ahí está, en mi opinión, la clave de todo. Cuanto más tarde aparece un fallo, más cuesta corregirlo, y no hablo solo de dinero. Un error que salta mientras escribes el código se arregla en un momento; ese mismo error, cuando ya está en producción, te cuesta una tarde entera y algún disgusto. No es lo mismo.
CI y CD no son lo mismo
Aquí conviene hacer una distinción, porque mucha gente usa las dos siglas como si fueran sinónimos y no lo son.
- Entrega continua: el código queda siempre listo para desplegarse, pero el paso final lo aprueba una persona. El equipo decide cuándo se libera.
- Despliegue continuo: el código se despliega solo, sin intervención humana, una vez pasan todas las pruebas.
Lo habitual, y creo que es lo sensato, es empezar por la entrega continua, con esa aprobación manual, y dar el salto al despliegue automático cuando uno ya se fía de sus pruebas.
Las fases de un pipeline
Un pipeline de CI/CD no es más que una secuencia de pasos que lleva un cambio desde el repositorio hasta producción. Estas son las fases que suelen aparecer:
| Fase | Para qué sirve |
|---|---|
| Compilación | Convertir el código en artefactos ejecutables |
| Pruebas unitarias | Verificar cada componente por separado |
| Análisis estático | Revisar la calidad sin ejecutar el código |
| Pruebas de integración | Comprobar que las piezas encajan entre sí |
| Pruebas de seguridad | Buscar vulnerabilidades |
| Despliegue | Instalar en staging o en producción |
Lo que se gana con esto
Cuando el pipeline funciona bien, los beneficios se notan, y se notan bastante:
- Los errores aparecen en minutos, no en días.
- El riesgo baja: los cambios pequeños son más fáciles de revertir.
- Se entrega más rápido, porque el tiempo entre un cambio y su despliegue se acorta.
- Todo el mundo ve el estado del código, sin preguntar por mensajería.
El error de "esto en mi máquina funciona"
Hay una frase que resume bastante bien por qué merece la pena todo este montaje, y es la de "en mi máquina funciona". La reproducibilidad de un pipeline, esa que hace que cada build sea idéntico, es justo lo que elimina ese problema. Si el entorno es el mismo para todos, las sorpresas se reducen mucho.
Y qué relación tiene con DevOps
Conviene aclarar que CI/CD es una parte del DevOps, no el DevOps entero. El DevOps incluye también la infraestructura como código, los contenedores, la monitorización y esa cultura de colaboración entre desarrollo y operaciones que, al final, es la que sostiene todo lo demás. CI/CD automatiza la entrega; el DevOps, digamos, cambia la forma de trabajar.
Si quieres ver cómo montar las pruebas que sostienen todo esto, en la entrada sobre tests unitarios en PHP lo cuento con un ejemplo concreto.